
Pipeline CI/CD : automatiser ses déploiements
Pipeline CI/CD : automatiser ses déploiements pour sortir du mode pompier
Un vendredi à 17h30, bug critique en production. Le développeur qui « sait comment on déploie » est en congé. Quelqu'un d'autre doit prendre la main, mais il y a ce script qui traîne sur le bureau de Pierre, des variables d'environnement copiées dans un bloc-notes et une séquence de commandes SSH que personne d'autre n'a jamais eu besoin d'exécuter. Le correctif met deux heures à partir. Le client a attendu.
Ce scénario, presque chaque équipe de 3 à 5 développeurs l'a vécu. Les habitudes de livraison se forment quand l'équipe est petite, que ça marche et qu'on ne touche pas à ce qui marche. La rigueur de l'équipe n'a rien à voir là-dedans.
Ce que cache le « ça marche depuis toujours »
L'analogie la plus juste pour décrire le déploiement manuel reste celle-ci : conduire sans ceinture de sécurité. Sur les petites routes que vous connaissez par cœur, vous n'avez jamais eu d'accident. Donc la ceinture, c'est pour les autres, ou pour les autoroutes. Ça fonctionne, jusqu'à ce que ça ne fonctionne plus. Et quand ça arrive, c'est violent.
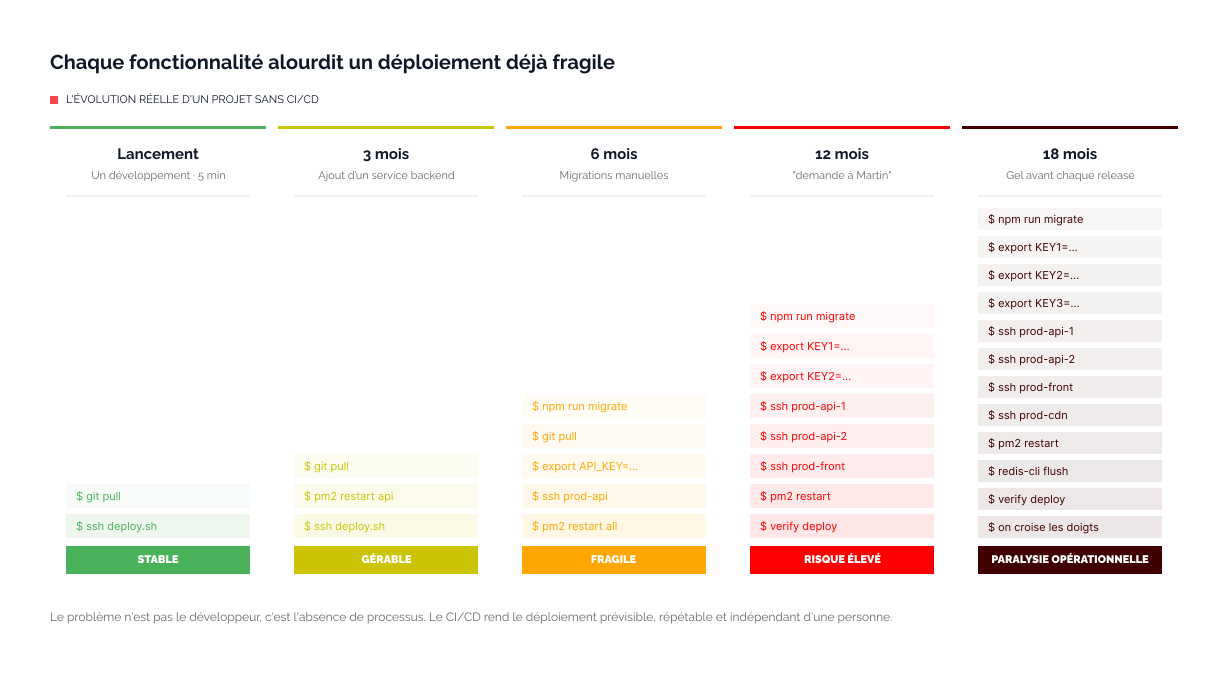
Le déploiement manuel fonctionne bien quand la base de code est petite, quand l'équipe se connaît depuis le début, quand personne n'a jamais raté une étape. Il accumule de la dette opérationnelle en silence. Pas dans le code, dans la tête des gens.
La « freeze de features » s'installe progressivement. À mesure que la base de code grossit, les déploiements font peur. On les reporte. On les regroupe. Un déploiement tous les quinze jours plutôt que plusieurs fois par semaine, parce qu'on ne veut pas « casser quelque chose avant le week-end ». Les correctifs attendent. Les petites améliorations s'accumulent dans une branche. La mise en production devient un événement à risque plutôt qu'une routine.
La dépendance à une personne s'installe en même temps. Dans la plupart des équipes, il y a toujours quelqu'un qui « sait comment on déploie ». Pas parce que les autres sont incompétents, mais parce que personne n'a eu intérêt à documenter et automatiser ce qui marchait déjà. Cette personne devient un goulot d'étranglement. Quand elle est absente, en réunion, ou simplement occupée sur autre chose, tout s'arrête.
Et puis il y a le temps perdu : le plus insidieux parce que personne ne le comptabilise. Un déploiement manuel prend du temps : SSH, vérification des logs, copie de fichiers, redémarrage des services, surveillance que ça tient. Une heure, parfois deux. Plusieurs fois par semaine. Rapporté au taux horaire d'un développeur senior, ce temps est un coût réel qui n'apparaît dans aucun tableau de bord.
Ce qu'est (vraiment) un pipeline CI/CD, sans jargon
Le terme CI/CD fait peur parce qu'il est associé aux grandes structures tech, à Kubernetes, à des équipes DevOps dédiées. Ce n'est pas la réalité pour une PME qui démarre.
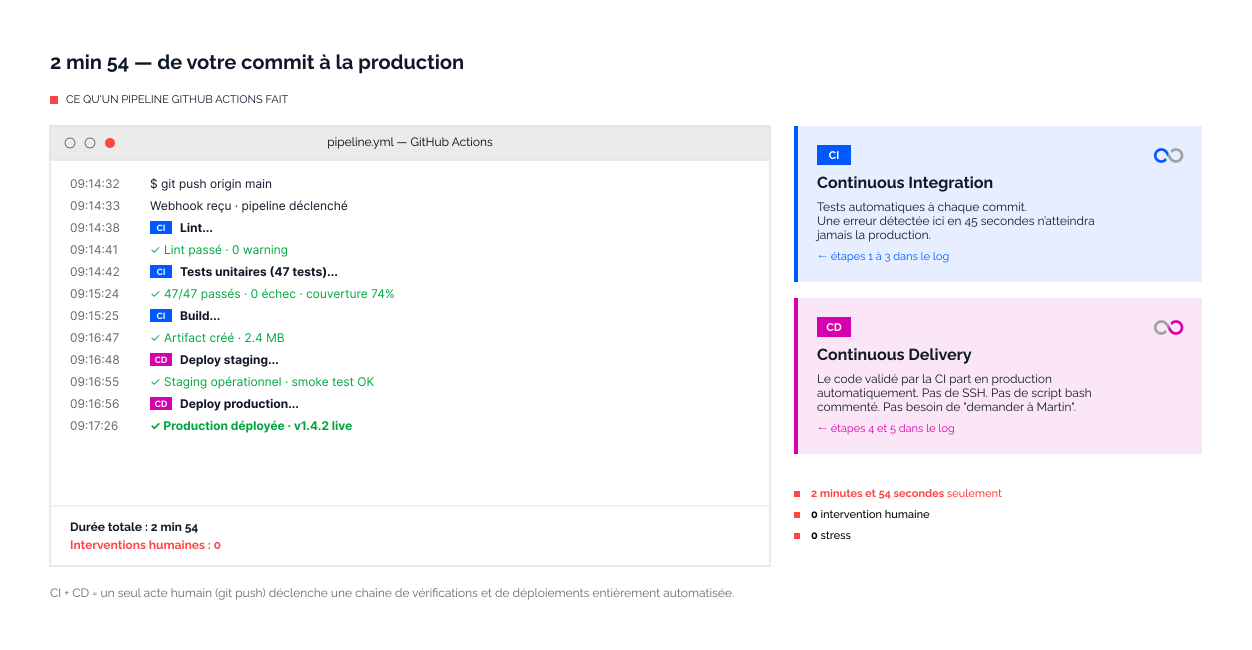
CI signifie Continuous Integration. Chaque fois qu'un développeur pousse du code, une série de vérifications automatiques s'exécute. Les tests tournent. Le code est analysé. Si quelque chose est cassé, le développeur en est informé immédiatement, pas trois jours plus tard quand un collègue tombe dessus par hasard, ou pire, quand un utilisateur le signale.
CD signifie Continuous Delivery (ou Deployment). Si ces vérifications passent, le code peut être déployé automatiquement vers un environnement - staging d'abord, production ensuite, selon la configuration choisie. Sans qu'un humain doive se connecter quelque part et taper des commandes dans le bon ordre.
Ce qui change concrètement pour une équipe : déployer n'est plus un acte manuel qui demande de la concentration, des connaissances spécifiques et du temps bloqué. C'est une conséquence automatique d'un pull request validé. Et si le déploiement détecte un problème, le rollback se fait de la même façon.
L'outil n'a pas d'importance autant que les équipes le craignent. GitHub Actions, GitLab CI, Bitbucket Pipelines - ces trois options couvrent 95 % des besoins d'une PME. Elles sont intégrées directement dans les plateformes que les équipes utilisent déjà. Pas besoin de Jenkins sur un serveur auto-hébergé avec quelqu'un pour le maintenir.
Les 3 gains concrets pour une équipe
La vélocité, dans le sens concret du terme : n'importe qui dans l'équipe peut déployer, sans attendre quelqu'un de spécifique. Ça change l'organisation du travail : les correctifs urgents n'attendent plus la disponibilité d'une personne précise. Les développeurs juniors peuvent livrer des features sans supervision directe à chaque déploiement. L'équipe entière avance, pas seulement le senior qui détient la connaissance opérationnelle.
La qualité est le gain qui justifie le plus souvent l'investissement initial. Les tests automatiques dans un pipeline CI détectent les régressions avant qu'elles atteignent les utilisateurs. Un bug introduit un mardi matin est détecté avant le merge du mardi après-midi, pas signalé par un client le vendredi soir. La différence en temps de debug et en stress est considérable. On sous-estime chroniquement le coût d'un bug trouvé en production par rapport à un bug trouvé en développement.
La sérénité. Une production qui part en trois minutes de façon automatisée, sans qu'un humain doive se concentrer et ne pas se tromper dans la séquence, c'est une charge mentale en moins pour toute l'équipe. Une équipe moins stressée par ses déploiements livre plus souvent - et c'est là que tout s'enchaîne.
Le chemin des PME qui passent au CI/CD
La question qui revient le plus souvent n'est pas « est-ce que CI/CD c'est une bonne idée », ça, les CTO le savent généralement. La vraie question, c'est « par où on commence sans tout casser et sans y consacrer six mois ».
La réponse honnête : progressivement, et dans l'ordre.
-
Le versioning propre : Branches de feature, pull requests avec review, convention de nommage cohérente. Sans ça, automatiser le déploiement ne fait qu'accélérer le chaos. Ce n'est pas spectaculaire, mais c'est le fondement sur lequel tout le reste s'appuie.
-
Quelques tests automatisés : Même 20 % de couverture, c'est mieux que zéro. Des tests simples, pas exhaustifs - un test qui vérifie que l'API répond, que la connexion à la base tient, que les routes principales retournent les bons codes. Basique, mais déjà utile.
-
Le premier pipeline : lint et tests qui tournent automatiquement sur chaque pull request. GitHub Actions rend ça accessible en une heure pour quelqu'un qui ne l'a jamais fait. Le fichier de configuration tient en vingt lignes de YAML. C'est suffisant pour commencer à en tirer de la valeur dès la première semaine.
-
Le déploiement automatique vers un environnement de staging : Dès qu'une PR est mergée sur la branche principale, le code part en staging sans intervention humaine. L'équipe peut valider visuellement avant de pousser en production.
-
Déploiement en production avec rollback automatique : Si le déploiement détecte une anomalie - checks de santé qui échouent, taux d'erreur qui monte - il revient automatiquement à la version précédente. C'est le niveau de maturité qui transforme les déploiements d'événements stressants en actes banals.
Personne ne passe de l'étape 1 à l'étape 5 en une semaine. Certaines équipes mettent trois mois, d'autres six. Ce n'est pas grave, ce qui importe, c'est de ne pas rester indéfiniment à l'étape 0.
Les erreurs à éviter quand on commence
La plus fréquente consiste à vouloir tout automatiser d'un coup. Un projet CI/CD qui dure six mois avant de livrer quoi que ce soit finit abandonné ou mal utilisé. Mieux vaut un pipeline minimal qui tourne dans deux semaines qu'une architecture parfaite qui n'existe pas encore.
La deuxième, c'est de brancher un pipeline sans avoir de tests. Automatiser un déploiement sans vérification automatique accélère surtout la livraison de bugs en production. Le pipeline n'a de valeur que si quelque chose valide que le code fait ce qu'on attend de lui.
La troisième se voit moins venir : choisir l'outil pour sa popularité plutôt que pour son adéquation avec l'équipe. Jenkins est puissant mais demande une maintenance sérieuse. Pour trois développeurs qui travaillent déjà sur GitHub, GitHub Actions suffit.
Une dernière chose, parce qu'elle revient souvent comme objection : « on n'a pas le temps de mettre ça en place ». L'investissement initial existe, c'est vrai. Mais il se récupère vite. Un pipeline basique installé en deux jours se rentabilise en quelques semaines si l'équipe livre régulièrement, et libère du temps sur des tâches à bien plus forte valeur que de taper des commandes SSH.
Ce que ça change vraiment
Le déploiement artisanal, c'est une forme d'obsolescence opérationnelle. Elle ne se voit pas dans le code, elle ne ralentit pas les performances de l'application - mais elle ralentit tout le reste : les livraisons, les corrections, l'onboarding de nouveaux développeurs qui doivent « apprendre comment on fait ici » avant de pouvoir contribuer seuls.
Passer au CI/CD, c'est sortir du mode pompier, où chaque déploiement est une intervention manuelle avec son lot de stress et de risques. Pour entrer dans le mode ingénierie, où livrer du code est une conséquence naturelle du travail, un acte banal plutôt qu'un événement qu'on redoute.
Cette obsolescence opérationnelle est le pendant invisible de la dette technique logicielle : elle ne se lit pas dans le code, mais elle ralentit tout ce qui s'y rattache. Chez Connexia, c'est l'un des premiers chantiers que nous ouvrons sur les applications métier que nous reprenons en maintien en condition opérationnelle.